04 哈希函数
密码学中的哈希函数(hash functions)和通常意义下的哈希函数一样,都起到“把复杂对象映射到简单对象”的功能。从二进制串的角度,哈希函数能把长的二进制串映射到短的二进制串。
抗冲突性(Collision Resistance)
正是因为定义域总比值域更大,所以数学意义上哈希冲突(collision)是不可避免的。所以我们不可能设计出一个没有哈希冲突的哈希函数。但我们容易设想,在密码学的背景下,我们只需要保证哈希函数在多项式次查询下发生冲突的概率可忽略就行了。下面我们需要严格定义怎样的哈希函数是抗冲突的(collision resistant)。
一个自然但是错误的想法是,对于一个哈希函数,我们让敌手参加以下实验:敌手可以不断选择计算出,重复多项式次;最终敌手选出,如果就称敌手成功。如果任何敌手成功的概率都,就称是抗冲突的。这样的定义是显然有问题的,因为我们知道从数学上哈希冲突一定存在,因此对于每个给定的哈希函数一定存在一个直接输出这对哈希冲突的敌手。换言之如果采取上面这种定义,任何一个哈希函数都不是抗冲突的。
因此,为了定义一个合理的抗冲突性,我们需要引入key ,把哈希函数看作关于和自变量的二元函数,称为keyed hash functions。一个keyed hash function是一个二元组,其中是key的生成器,输入,输出(这里我们不要求的长度必须是,但我们要求至少要有一个规则使得我们能从中推出的大小)。是一个确定性的函数,输入一个任意长度的01串,输出一个关于的确定值。我们要求,也即哈希函数的输出值的长度是固定的关于的函数。记。通常,只接受长度大于的输入。另外,如果只接受固定长度的输入,我们就称是一个定长哈希函数,又称为压缩函数(compression function)。现在我们可以设计一个实验定义keyed hash function的抗冲突性:对于一个哈希函数,我们让敌手参加以下实验:输入给,得到key ;把交给敌手,敌手可以不断选择计算,重复多项式次;最终敌手选出;如果就称敌手成功。如果任何敌手成功的概率,就称是抗冲突的。
注意在以上定义中,是给定敌手的,这等价于敌手拥有一个询问哈希函数值的oracle,它可以查询该oracle多项式次。
The Merkle-Damgard Transform
在实际中,输入串为定长的哈希函数要比输入串不定长的哈希函数更好构造。假设我们已经构造得到了一个定长的collision-resistant的哈希函数,能否基于它构造一个输入不定长的collision-resistant的哈希函数呢?答案是肯定的,下面我们给出Merkle-Damgard变换,它用类似链式块密码的方式实现了从定长输入到任意长输入的延拓。
选定两个整数。设哈希函数是到的映射。我们可以固定一个,满足,此时我们构造一个中长度不超过的串到的哈希函数。可见我们其实并不能构造一个完全任意长输入的哈希函数,但这个范围已经完全够用了,可以认为是任意长了。具体构造方法是:对于输入串,首先做第一次padding(先在末尾加个1,然后加若干个,使得总长度满足“加以后是的倍数”),然后把的长度转成一个位二进制串(因为长度不超过这一定是能做到的),再padding到后面。可见这时候输入串已经被padding为一个长度是的倍数的串了,我们可以把它每位看作一个block,得到了个block 。我们选定一个,令,输出作为的结果。
我们来证明以上构造满足:如果是collision-resistant的,那么也一定是collision-resistant的。我们观察到以下性质:假设存在,那么分类讨论。如果,那么由于我们用长度做了最后部分的padding并且每个block的长度大于,因此padding之后与的最后一个block一定不同,所以作为输出的如果与,就说明与是一对上的哈希冲突;如果,此时最后一个block可能相同,但由于一定会存在一个不相同的block,我们取最右侧的不相同的block,就又得到了一对上的哈希冲突。基于以上观察,很容易用归约完成证明。让攻击的敌手观察攻击的敌手,每当发现冲突,就可以基于上述观察构造出一个关于的冲突,所以冲突的概率一定大于等于冲突的概率,而冲突的概率是的,所以冲突的概率也是的。证毕。
攻击哈希函数
对哈希函数的攻击就是去寻找一个给定哈希函数中的冲突。首先,在任何时候敌手只需任取个互不相同的输入计算对应的哈希值。根据鸽巢原理,这样一定能找到至少一个冲突。如果少于个,那么不一定能保证发现哈希冲突。我们假设敌手随机sample 个不同的输入,计算能找到哈希冲突的概率。
以上概率是关于具体的的构造的,并不具有一般性。有的哈希函数构造的好,概率会较低;构造的不好的,概率会较高。怎么样的哈希函数是好的哈希函数呢?一个好的哈希函数应当尽可能把不同的映射到不同的-bit串,这样做的结果是的值域接近于的均匀分布。在现实中这并不容易做到,因为我们只有多项式的时间,无法保证所有输入上的分布足够均匀。而不好的哈希函数则会使值域聚集起来而不是散开。所以当我们分析敌手攻击成功的概率的时候,我们可以假设是上的均匀随机的函数,这样做只会加大敌手的难度而不是降低。在假设了是一个均匀随机的函数以后,对于敌手的攻击的分析就等价于:在中随机sample 个数,有多大概率产生重复?这就是经典的birthday collision问题,我们知道个人就有的概率生日重复,个人就有的概率生日重复。当人数是天数的根号量级时,冲突概率是常数量级,接近。因此,对于,只需sample 次就有大约的概率成功攻破该哈希函数。换言之,如果我们想让一个有时间步数资源的敌手不能攻破一个哈希函数的话,至少需要一个的哈希函数。
哈希函数的应用
Fingerprinting
基于哈希函数,比较两个文件是否相等只需比较这两个文件的哈希值,而不需要比较全文。这为我们节省了大量计算资源,并且collision-resistant保证了这样做只会以微小的概率出错。文件的哈希值就成为这个文件的fingerprint(指纹)。例如,当受到恶意软件攻击时,只需比较该软件的指纹与数据库中已有的病毒的指纹,就可以快速识别该病毒;当数据库中有两个哈希值相同的文件时,我们只需保留其中一个删去冗余的那个;等等。
Merkle Trees
哈希函数可以用来校验文件。我们把一个文件上传到云盘存储,在本地不储存该文件而只存该文件的哈希值,当我们从云盘上把文件下回来时可以计算下载的文件的哈希值,如果该哈希值发生改变我们就会意识到该文件被修改过了。
假设一个用户把个文件上传到云盘,如果还是采取刚才的方法,就需要在本地存储个哈希校验码。但这样随着上传云盘的文件越来越多,本地需要存储的哈希码数量也线性增长。另一种方法时,本地存储这个文件合并在一起的哈希码,这样本地只需存储一个哈希码,但这样为了在下载时校验是否被修改需要下载云端的所有文件才能计算出哈希值,效率太低。
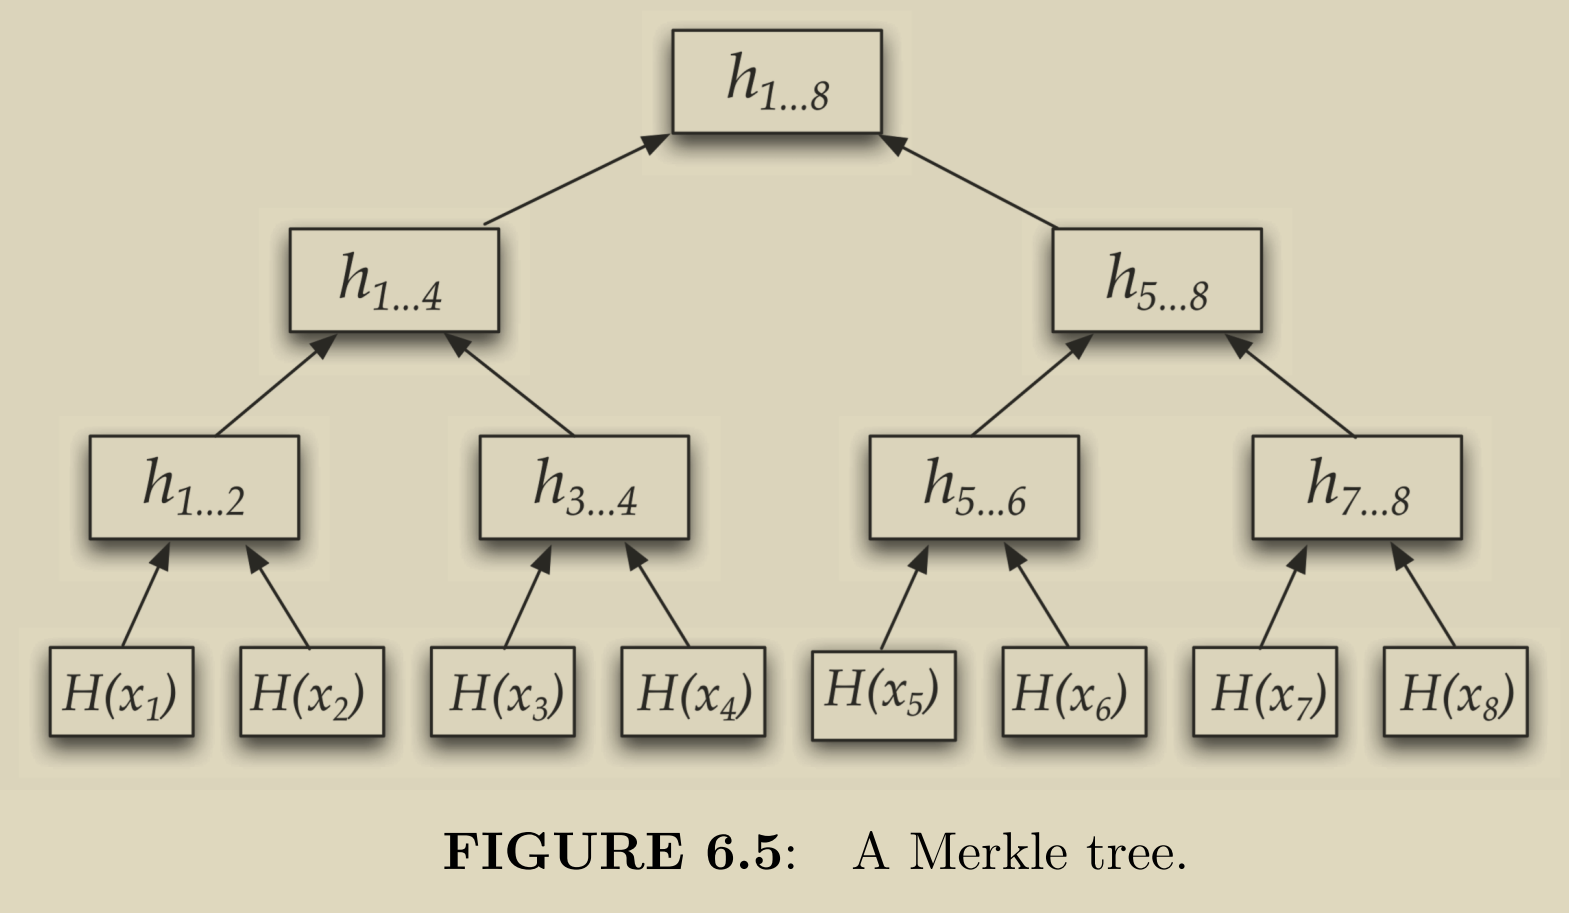
Merkle提出了一个折衷方案,在云端用线段树来存储哈希码。不失一般性假设。当用户上传文件时,首先计算,把这看作线段树的叶节点,接下来依次计算,记为(倒数第二层,注意到哈希函数的输入是不定长的),最后计算出根节点。注意,本地只存储根节点的哈希值, 但是把整棵线段树(以及文件)都上传到云盘。当下载一个文件时,一并下载云盘上的线段树在叶节点到根的路径上的所有节点的兄弟节点的哈希值。这样我们可以在本地计算出,然后通过下载的哈希值可以一路计算出根节点的哈希值,与原先存储的哈希值做比较。可以证明,只要是collision-resistant的,这样校验的出错概率是的。并且注意到,整个校验过程的复杂度是的。
Password Hashing
在注册设备或者网站账号时需要输入password,这个password需要设备或网站存储,这样才能在登录时验证身份。但是如果password直接存储在设备或网站上,一旦存储泄露,攻击者就可以登录你的账号。一个方法是,在设备或网站上只存储密码的哈希值,验证身份时比较你输入的密码的哈希值是否与存储的哈希值相同,这样即便存储泄露攻击者也只得到了哈希值。如果哈希函数是collision-resistant的,可以证明它也是preimage-resistant的(抗原像攻击的),也即给PPT敌手一个,它只能以的概率找到一个使得。这样就保证了即便内存泄漏,密码本身不会被泄露。
然而如果password的空间比较小,那么敌手总是可以暴力枚举所有可能的串来攻破。并且由于人脑只能记住熵比较小的字符串,敌手可以优先枚举那些字符串,这样就可以更快攻破。对于小的password空间,有这样一种加salt(盐)的方法:当用户输入一个password 时,服务器(或者主机)生成一个长的01串,称为salt。服务器代替人脑记住这个salt,然后存储哈希值。如果salt没有泄露给敌手,那么我们就成功把小空间的password变成了大空间的password(当然如果salt泄露了就和没有salt没有区别了)。