Information Channel
信息是消息(message)的概率分布,消息是物质按照特定结构的排列。所谓“通信(communication)”就是把某一时间地点的某一物质排列在另一个时间地点再现,也就是消息的传递。要完成消息的传递,需要实现一个物理系统,这个用来传递消息的物理的系统就称为信道(channel)。在物理世界中建立信道传递消息,不可避免地会受到干扰。信息论的最重要的问题之一,就是如何在信道受到干扰的情况下准确、高效地传递信息。
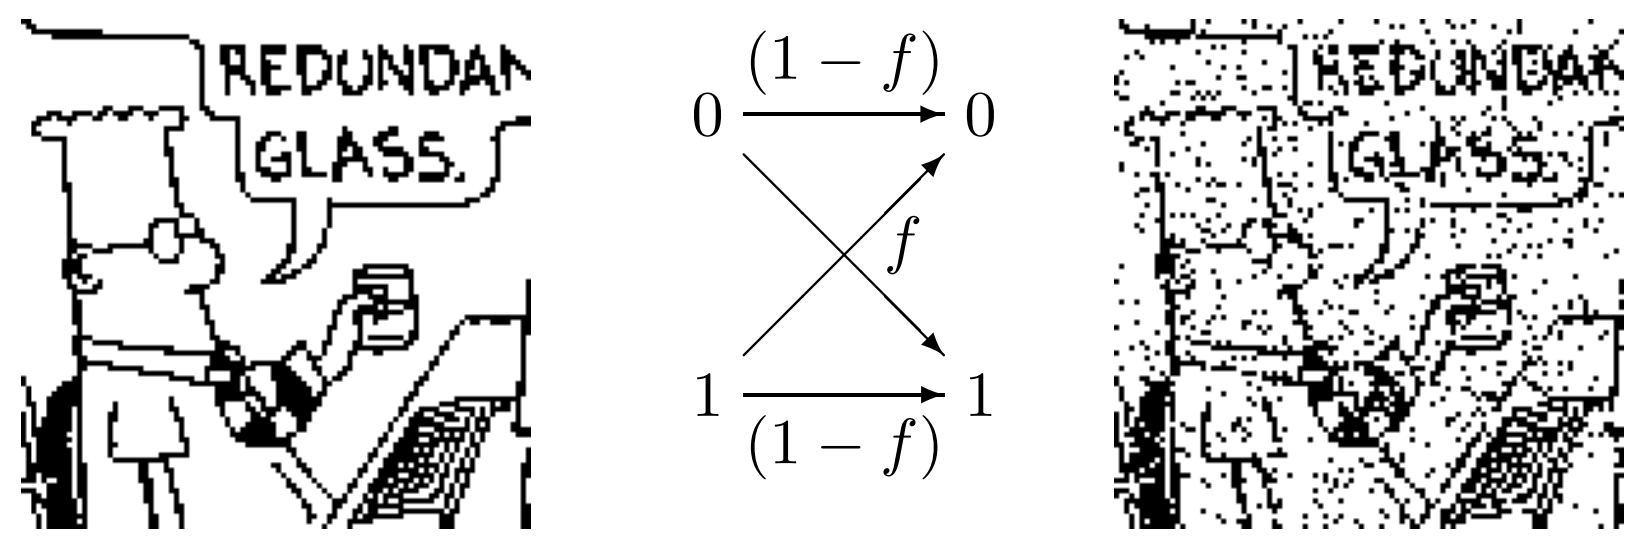
让我们先来看一个最简单的信道。这个信道单位时间只能发送0或1两种字符,每种字符都有f的概率会受到干扰变成另一种字符。这称为一个二进制对称信道。上面是一个用f=0.1的二进制对称信道发送黑白像素图片的示例,可以看到图片受到干扰后出现了很多噪点,但是其基本轮廓依然清晰可见。这就是物理世界里受干扰的信道传输消息的现实状况。
为了降低信道所受的干扰,人们可以选择加强信道的物理系统。例如,增强用于储存信息和传送信息的磁场强度,以降低信息受到干扰的概率(也就是上面的f)。让我们把这类方法统称为物理方法,这不是信息论要讨论的对象。信息论要讨论的是不改变信道的物理构造的前提下,是否存在算法层面(computational)的方法,来提高信道传递信息的效率和准确率。
例如,我们容易想到这样一个算法层面的方法来提高二进制对称信道的准确率:对于每个待发送的二进制位,用该信道重复发送n遍,接收方通过观察收到的n个二进制位中0多还是1多来确定原始发送的二进制位是什么。容易想象,当n非常大的时候,这种做法的准确率是极高的。不过,n越大,我们就要做越多的重复发送,因此信道的效率就越低。可见信道的准确率和效率是一对互相牵制的矛盾。
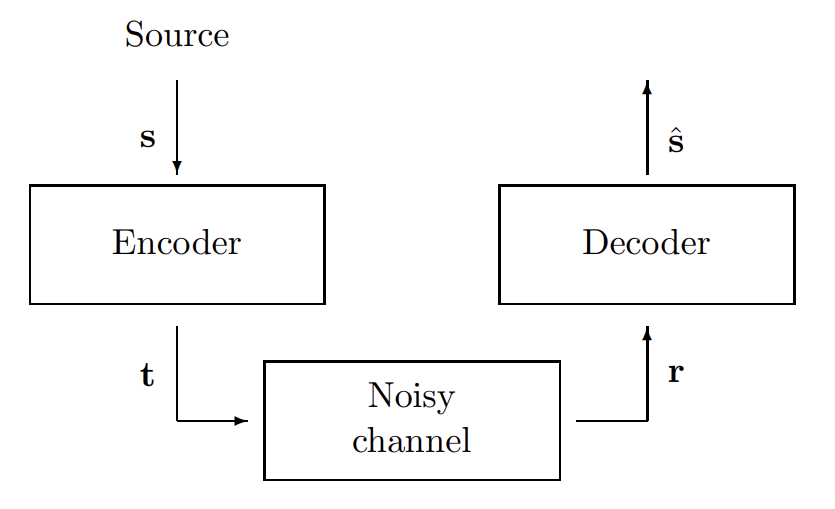
所有用以增强信道准确率的算法设计基本都可以总结为下图。对于原始要发送的消息s,首先要经过一个encoder编码为t,这对应于上面“把一个位重复发送n遍”的操作。把编码后的消息t用信道传送,接收方再通过decoder解码出s^,这对应于我们上面“通过判断哪种字符多来还原原始字符”的操作。
Remark: 在这里encoder的作用是为待发送的消息增加冗余信息,以提高其抵抗干扰的能力。这与信息压缩相反,信息压缩尽量去除信息冗余,而信道编码增加信息冗余。
下图是用上面的“重发n次”算法发送黑白像素图片的示例:
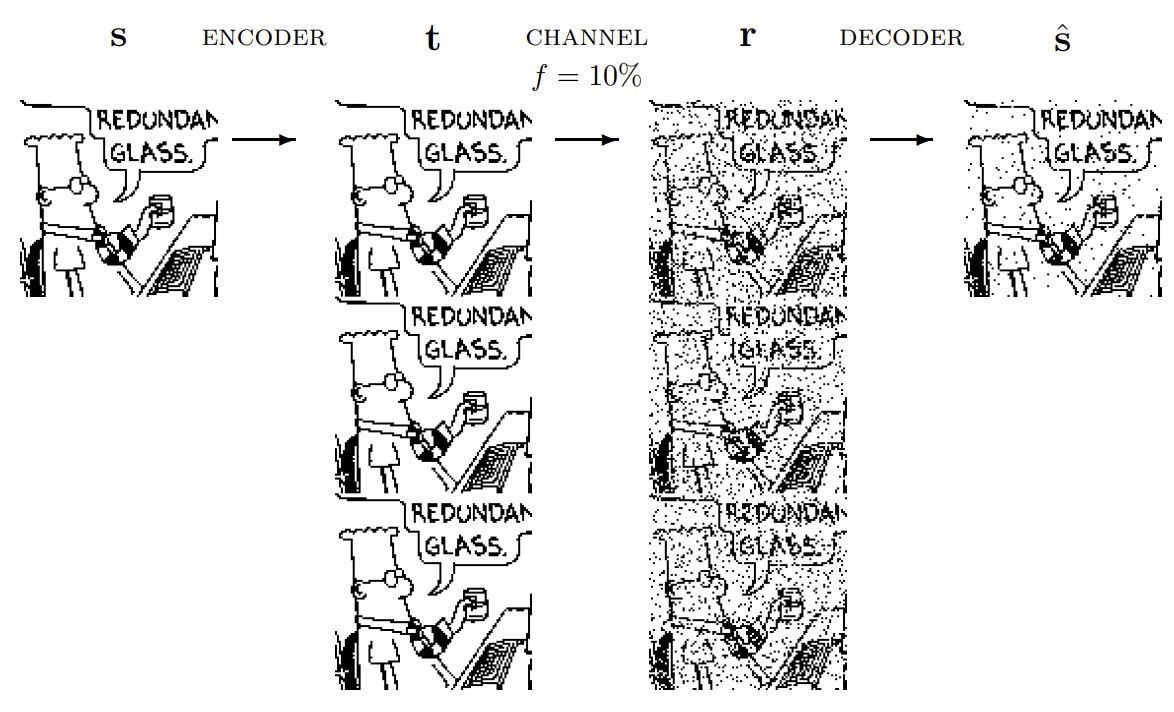
可以看到,相比于直接发送,噪点减少了许多。当然,这消耗了我们更多的算力。原本一个二进制位受干扰而出错的概率是f。让我们来计算一下“重发n次”算法下一个二进制位的出错概率。不妨设n为计数,decoder解得的s^=s当且仅当n次重发中有至少(n+1)/2次出错,因此总的出错概率为k=(n+1)/2∑n(kn)fk(1−f)n−k。当n=3,f=0.1时,代入可得出错概率为0.028。
再来看另一个信道编码算法,这个算法称为(7,4)-海明码(Hamming Code)。“重发n次”的算法是对于待发送的源码按单个位进行编码后发送的,而新的这个算法会把源码4个位一组打包后编码发送。编码方式如下图所示,对于待发送的源码串s1s2s3s4,计算二进制不进位加法t5=s1+s2+s3,t6=s2+s3+s4,t7=s1+s3+s4(相当于“奇偶校验”),将这三位附加在源码后,生成7位的编码。例如,当s=1000时,编码得到t=1000101。接下来我们需要设计一个解码算法。把decoder接收到的7位串也放进这三个圈里。首先注意到,一个未受干扰的7位串一定满足每个圈内求和为偶数。不过,每个圈内求和为偶数并不意味着其未受干扰,因为可能同时有多个位受干扰。根据每个圈是否受到干扰,共有23=8种可能情况。不难发现,对于每种情况,一定存在一个位恰好属于所有受干扰的圈,且不属于所有未受干扰的圈。只需对这样的一个位做取反操作,立即能得到一个每个圈求和都为0的7位串s^。我们就把此作为解码算法。例如,若r=1100101,解码得到s^=1000101;若r=1101101,解码得到s^=0101101。
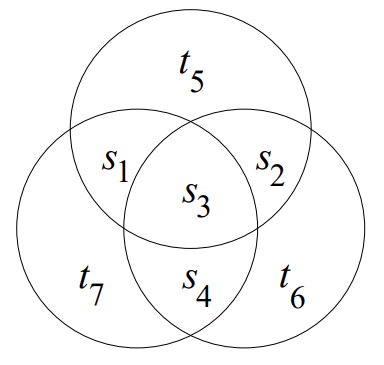
对于上面这个解码算法来说,如果恰好只有一位受干扰,那么解码算法一定正确。然而如果不止一位受干扰,那么解码算法一定错误,因为解码结果只会改变接收到的串中的一位。由此可见,如果每一位都用f-二进制对称信道发送,那么发送一个4位包的出错概率就是k=2∑7(k7)fk(1−f)7−k。分摊到每一位上,出错概率是O(f2)级别的,和“重发n次”算法的出错概率数量级相同。然而,相比于“重发n次”算法,我们增加的冗余只占到源码的3/7,效率提高了许多。
海明码可以从3维推广到n维,也就是(2n−1−n,2n−1)-海明码。随着n的增大,其冗余比越来越低,但是出错概率却越来越高:无论n多大,海明码对于每个块只会纠一个错,所以分摊到每一位上的出错概率随n指数增大,正比于块的长度。
信息论关心的问题是,一个最好的信道编码算法能做到什么程度?我们已经通过上面两个例子看到“错误率”和“效率”是一对互相牵制的因素,要使得错误率越低,效率也会越低。人们之前一直以为即便是最好的编码算法,要使得错误率趋向0,信道的效率也会趋向0。然而香农(Shannon)证明了,当错误率趋向0时,效率可以趋向一个常数值,这个常数值就被称为这个信道的“容量(capacity)”。这就是信息论中最著名的信道编码定理。
“通信”到底是什么?严格地说,当我们说A与B通信时,我们指的是A通过一些物理作用改变了B的物理状态。在这个物理作用的过程中,完成了信息的传递。我们之所以要讨论通信,是因为物理世界的复杂性导致在信息传输过程中,噪声(noise)干扰导致的信息损失是不可避免的。某种意义上,信息传输和信息编码是一种相反的过程。对于编码来说,一个长度为n的随机二进制串的信息量总是不超过logn,这是因为随机变量的分布中存在冗余;而在信息传输中,由于干扰的存在,我们总是需要传输比信息量更多的位数才能保证消息被准确无误地接收到。在信息论中,我们定义信道(Channel)来描述这个信息传递的过程。在信道中,A要传递某个消息,那么它首先要用字符集X把这个消息编码成某个长度为n的字符串Xn。接着,这个信息要经过信道传送到B。在传送的过程中,Xn受到噪声干扰以至于B在接受信息时得到的是某个字符集Y的某个长度同样为n的字符串Yn。当B把Yn转译成能够理解的形式以后,信息传递的过程就完成了。
从以上信息传输的过程中我们能看到,信息传递的准确性就取决于由Xn转变成Yn的过程。为此,我们可以用一个概率分布p(yn∣xn)来刻画信道。如果X,Y都是有限的,我们就称它为一个离散信道(Discrete Channel)。如果p(yn∣xn)=i=1∏np(yi∣xi),就称为离散无记忆信道(Discrete Memoryless Channel),记为(X,p(y∣x),Y)。
假设总共有M条可以被传输的信息。对于任何一个待传输的信息,我们总可以把它和一个自然数i对应起来,i∈{1,⋯,M}。设把i映射成xn的映射(encoder)为f,把yn映射到自然数的映射(decoder)为g。那么定义出错的条件概率(Conditional Probability of Error)为λi=Pr[g(Yn)=i∣f(i)=Xn]。根据全概率公式,这等价于yn∑p(yn∣xn(i))⋅1[g(yn)=i]。把可能的最大的出错概率记为λ(n)=i∈[M]maxλi,平均的出错概率记为Pe(n)=M1i∈[m]∑λi。
注意,当我们假定M以后,意味着信道只可能发送M条不同的信息。这意味着,即使我们什么也不发送,接收者也知道一旦发送,它也只会收到这M条中的某一条。如果我们假设所有消息被发送的概率是相等的,这意味着一条消息的不确定性(信息量,熵)就是logM。而为了传递这条消息,我们将会传输字符n次,因此我们称这次传输的码率(rate,单位是bit)为R=nlogM。这反应的是本次传输中每传输一个字符时平均而言传递了多少信息量,在均匀分布的前提下,码率为R意味着一个字符传输2R的信息量。自然地,一个信道受干扰越多码率就会越低。一个信道在传递信息时产生的码率变化情况既与我们传输信息的方案有关,也和信道本身受到的干扰有关。假如我们总是以最好的方式传输信息,那么平均而言(大数定律意义下)一个特定的信道总有一个能够实现的最大的码率,这个最大的码率完全是由信道本身的性质决定的,对于离散无记忆信道而言,这就是由矩阵p(y∣x)决定的。对于一个信道,如果以码率R传输n位,总的信息量为(2R)n=2nR。如果这个信道用长度为n的Xn传递M=⌈2nR⌉(由于可能不为整数,我们做上取整)的消息时,能在n→∞时实现最大出错概率λ(n)→0,就称码率R是可实现的(achievable)。所有可实现的R的上确界定义为该信道的容量(Capacity)。
Channel Coding Theorem(信道编码定理)
Shannon在1948的论文中提出,离散无记忆信道(X,p(y∣x),Y)的信道容量C=p(x)maxI(X;Y)。这称为信道编码定理,是信息论中最重要也最基础的定理。它指出,信道容量恰好等于I(X;Y)随输入分布p(x)变化的上确界。同时,任何一个R<C的码率都是可实现的,也即存在M=⌈2nR⌉的长度为n的编码在n→∞时最大出错概率趋向0;反之,任何可实现的码率都必定满足R≤C。我们看到,这也为互信息这一概念提供了一种具体的意义。为什么会出现互信息?我们在渐进均分性下考虑这个问题。由于噪声的存在,可能有多个不同的xn受到干扰后落在了同一个yn上。信道的容量等价于接收者最多可以区分多少个不同的xn。Yn的典型集中共有2nH(Y)个字符串,而给定X我们只能知道yn落在对应的2nH(Y∣X)个字符串中,而不知道是具体哪一个。为了能够清楚区分所有xn,我们选取一个xn来对应这样的yn。因此,我们最多只能分辨2nH(Y∣X)2nH(Y)个字符串,也即2n(H(Y)−H(Y∣X))=2nI(X;Y)条不同的消息。因此码率不可能超过nlog2nI(X;Y)=I(X;Y)≤C。
对于任意固定的R,其中R<C,我们可以构造一个M=⌈2nR⌉的消息集使得n→∞时λ(n)→0。我们任意固定一个输入上的分布p(x)(x有M个可能取值),用这个分布随机生成M个长度为n的字符串xn,记为矩阵Cp。生成这样的特定的M个字符串的概率为Pr(Cp)=w=1∏Mi=1∏np(xw(i))。当我们要发送第w条消息时,我们就用信道传输字符串xwn。接收者此时为收到一条经过干扰的字符串yn。接收者采用这样一种基于渐进均分性的简单的解码策略:他认为yn应当解码为x^n,当且仅当x^n是Xn中唯一一个使得(x^n,yn)落在(Xn,Yn)的联合典型集里的。在这样的编码和解码策略下,我们可以证明最大出错概率趋向0,此处省略。
反之,我们要说明任何一个可实现的码率都不超过C。对于给定的R,如果存在M=⌈2nR⌉的消息集使得n→∞时λ(n)→0,那么设待发送的消息为W,它将被加密为Xn,经过传输得到Yn,再被接收方解码为W^。于是我们有马尔可夫链W→Xn→Yn→W^。假设W是均匀选取的,那么H(W)=logM=nR(忽略上取整)。根据韦恩图,总是成立H(W)=H(W∣W^)+I(W;W^)。根据Fano不等式(见下方注释),H(W∣W^)≤1+Pe(n)⋅log∣W∣=1+Pe(n)⋅nR。而又根据Data Processing不等式,I(W;W^)≤I(Xn;Yn)=H(Yn)−H(Yn∣Xn) =H(Yn)−H(Y1,⋯,Yn∣X1,⋯,Xn)=H(Yn)−i=1∑nH(Yi∣X1,⋯,Xn,Y1,⋯,Yi−1) =H(Y1,⋯,Yn)−i=1∑nH(Yi∣Xi)≤i=1∑nH(Yi)−i=1∑nH(Yi∣Xi) =i=1∑nI(Xi;Yi)≤nC。综上,nR≤1+Pe(n)⋅nR+nC,也就是说R≤n1+Pe(n)⋅R+C。当n→∞时,n1→0,Pe(n)→0,因此成立R≤C。
Fano's Inequality
假设X,Y是两个随机变量。我们给出一个基于Y预测X的函数g(Y)=X^,计算预测错误的概率Pr[X=X^]。
记E=1[X=X^]。H(E,X∣X^)=H(X∣X^)+H(E∣X,X^),而E是由X,X^定义的函数,因此H(E∣X,X^)=0。又有H(E,X∣X^)=H(E∣X^)+H(X∣E,X^)。同时,H(E∣X^)≤H(E)。根据条件熵的定义,H(X∣E,X^)=Pr[E=0]H(X∣E=0,X^)+Pr[E=1]H(X∣E=1,X^)。当E=0时,已知X^就是已知X,因此H(X∣E=0,X^)=0;当E=1时,H(X∣E=1,X^)≤H(X)≤log∣X∣。综上得到H(X∣X^)≤H(E)+Pr[X=X^]log∣X∣。这就是Fano不等式。
我们注意到,X→Y→X^形成了马尔可夫链。根据数据处理不等式有H(X∣X^)≥H(X∣Y)。同时,H(E)≤log2=1,所以Fano不等式可以弱化为1+Pr[X=X^]log∣X∣≥H(X∣Y)。化简得Pr[X=X^]≥log∣X∣H(X∣Y)−1。
事实上,在H(X∣E=1,X^)≤H(X)≤log∣X∣这一步放缩中,由于E=1,X实际上只有∣X∣−1个取值。所以可以得到一个更紧的界log(∣X∣−1)。所以Fano不等式更强的形式是Pr[X=X^]≥log(∣X∣−1)H(X∣Y)−1。
写了一半不想写的:的出错概率。我们先让分布p(x)变化,计算平均出错概率的期望:Pr(E)=Cp∑Pr(Cp)Pe(n)(Cp),代入Pe(n)=M1w∈[m]∑λw(Cp)得Pr(E)=M1w=1∑MCp∑Pr(Cp)λw(Cp)。由于我们是对任意Cp求和,而Cp的每一个字符串都是随机生成的,所以λw的下标取不同的值并没有实际的影响,可以认为下标恒取1。因此Pr(E)=Cp∑Pr(Cp)λ1(Cp)=Pr(E∣W=1)。也即在计算时,我们可以认为我们始终发送第一条随机生成的字符串。于是,只有以下情况可能出错:x1n与yn不在典型集里;存在i>1使得xin与yn在典型集中。由于我们总是发送第一条字符串,所以yn其实是与任何xin都独立的。根据联合AEP,Pr[(xin,yn)∈Aϵ(n)]=(xin,yn)∈Aϵ(n)∑p(xin)p(yn) ≤∣Aϵ(n)∣2−n(H(X)−ϵ)2−n(H(Y)−ϵ)≤2n(H(X,Y)+ϵ)2−n(H(X)−ϵ)2−n(H(Y)−ϵ) =2−n(I(X;Y)−3ϵ)。因此对于足够大的n,第一种出错概率不超过
参考资料
[1] Thomas M. Cover, Joy A. Thomas, Elements of Information Theory
[2] David J.C. MacKay, Information Theory, Inference, and Learning Algorithms