Entropy
什么是信息
“信息(information)”是什么?当我们看到一个数字,一个二进制串,一行乐谱时,我们通常会认为这些数据的形式本身就是“信息”。然而,在人们试图为关于信息的科学建立一套数学理论时却认识到,“信息”这一观念的本质并不在于单个数据所具有的形式,而在于这个数据还可能具有的所有其它形式。数字98本身并没有附带任何意义,而当我们焦急地等待考试成绩,并终于得知自己的分数是98时,带给我们这一信息的不仅是“我的分数是98”,同时还是“我的分数不是88”、“我的分数不是78”等等。当我们看到贝多芬为命运交响曲的开头时,我们不仅看到了开头的动机是G G G ♭E,我们还看到了开头的动机不是G G G E,也不是G G A ♭E,等等。所以香农(Shannon)强调说:“真正的关于信息的度量并不在于我们所发送的符号,而在于那些我们本可以发送却没有发送的符号。”从词源上看,"inform"即“告知”,也就是把“未知”变成“已知”。信息论是用概率论建模信息的科学。在信息论中,信息意味着概率空间的缩小。我们永远不能脱离具体的概率空间来讨论信息。
要度量信息的大小,其实就是要度量从概率空间坍缩到某一具体的样本上的难度。一本莎士比亚全集要比一本乱码信息含量高,因为猴子坐在电脑前乱敲键盘,敲出乱码的概率高于敲出莎士比亚全集的概率。通常,那些信息含量高的样本都拥有精巧的结构,物理世界的自然演化难以直接产生这些结构,而人类用这些结构交流感想、存储知识。因此,要给一个概率空间的每个样本在数学上定义一个信息量,这个信息量应该关于这个样本的概率质量pi呈相反方向变化:pi越小,信息量越大。
数学上关于“信息量”的度量最早是由香农在1948年发表的名为A Mathematical Theory of Communication的论文中给出的,并从此成为了信息论中的基本定义。对于离散的概率分布(p1,⋯,pn),香农把pi事件的信息量定义为logpi1。其实,并不存在非常显而易见的推导,来帮助我们理解这个表达式的含义。这个表达式的含义本身和“最优编码问题”有深刻的关联(对数的底数就是编码的进制数)。不过,我们可以结合若干具体的例子,沿着香农最早推出这个表达式的思路来感受这个表达式的含义。
例1:二进制通信
让我们首先来考虑一个“通信”的场景。A和B分别位于不同的房间内。A会在它的房间抛一个正八面体骰子。由于B在另一个房间,除非A把实验结果“告知”B,B始终处在“点数可能是1~8之间的任何数”的“未知”里。在实验前,A和B达成协议,用不同的二进制串来编码每种抛掷结果,每次实验结果通过对应的二进制串从A房间发送到B房间。不难发现,一个好的协议应当是用3位二进制串编码每一种可能情况。如果少于3个二进制位,B永远都不可能推断出A的实验结果究竟是什么。我们看到在这个例子里,概率空间的每个样本的概率都是1/8,按照香农定义的信息量,抛正八面体骰子时概率空间坍缩到每个样本所带来的信息量都是log21/81=3,恰好对应A和B所能达成的协议的最优编码方式。
有人会说,编码是去除前导零(把001编码成1,010编码成10,等等),平均而言不就可以少于3位了吗?这样的做法对于单次实验的确是有效的。但是如果A重复做了多次实验,那么当A发送111时,B如何区分这是三个001,还是一个111呢?所以一个好的通信协议应当约定不同的编码之间不能互为前缀,否则解码就会出现歧义。在不同编码不能互为前缀的约束下,的确至少要用3位才能完成上面的任务。
例2:天平称球
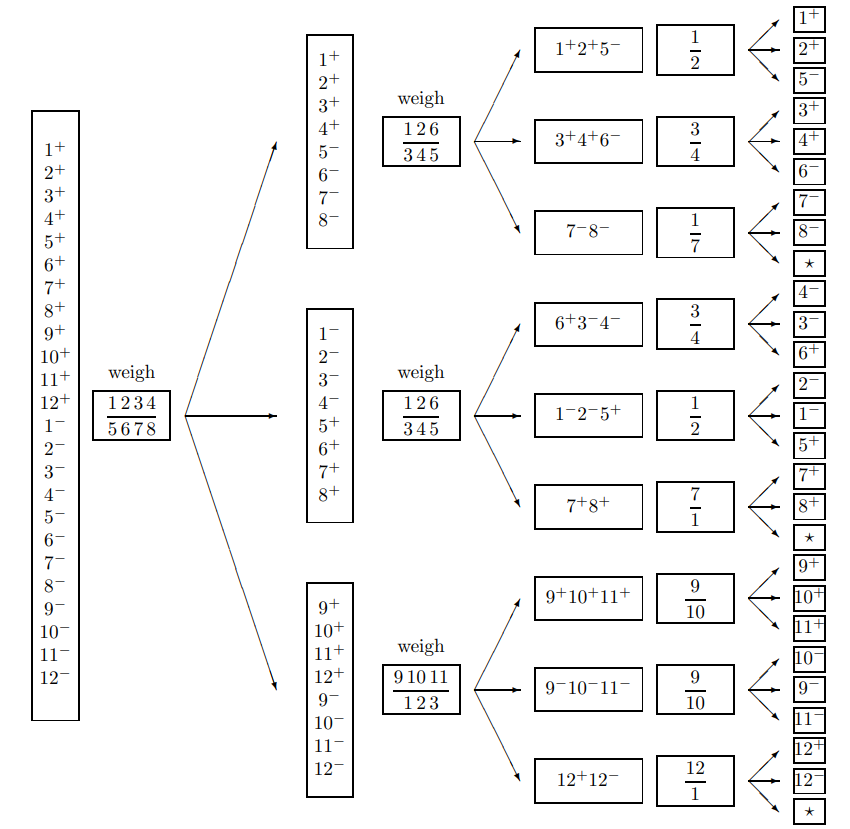
再来看一个“天平称球”的经典问题。已知12个外貌完全相同的球里恰好有一个重量与其它11个不同,可能是太轻也可能是太重;你有一座天平可以用来称球的重量,天平可以显示“左边更重、右边更重、一样重”三种状态,问最少称几次可以找出那个与众不同的球?经过分析,我们可以给出下图这样一个称3次的方案。在这个例子里,概率空间的每个样本的概率是1/24,按照香农定义的信息量,坍缩到每个样本所带来的信息量是log31/241≈2.89,略小于我们得出的“称3次”的结论。在这里,“每一次用天平称重”可以看作天平给出了一位三进制信息编码,“称3次”的结论意味着“12个小球里某一个与众不同”这件事编码为三进制串只需至多3位。
例3:多轮询问
再来看一些“多轮询问”的例子。A同学心里选定一个1到64的数字,B同学来猜这个数字。对于B同学的每个猜测,A同学只能回答“太大”或“太小”,直到B同学猜对。根据之前的经验,我们已经知道64个样本的等概率分布坍缩到其中一个的信息量是log264=6,所以应该存在一个至多猜6次的猜测方案。这个方案就是二分法,首先猜32,如果太大就接下来猜16否则猜48,等等。进一步,我们还可以考察A同学的每一次回答的信息量。如果B同学用二分法猜测,那么A同学的每一个回答都会让概率空间坍缩一半。“坍缩一半”相当于一个概率为1/2的随机事件(比如得知抛硬币的结果),所以A同学的每一个回答贡献了大小为1的信息量。重要的是,我们似乎可以把A同学的这6轮回答的信息量加起来,得出“A同学总共贡献了大小为6的信息量”的结论。如果我们把上面的例子改一改,改为A同学只能回答“是”或“不是”,那么:假如B同学直到最后才才对,那么A同学的第一轮回答只贡献log263/641的信息量,第二轮只贡献log262/631的信息量。把所有的64轮回答的信息量加起来,恰好是log26364+⋯+log212=log264=6。从这个例子中我们感受到“对数函数的加性”是香农选择用“对数”定义信息量的一个原因。
信息熵的表达式
通过以上这些例子,我们可以感受到概率空间坍缩到某一样本(组)所带来的信息量logpi1对应着编码事件pi所需要的符号串长度。在研究最优编码时,我们优化的目标是概率分布的平均编码长度,也就是
∑pilog2pi1
这一函数和统计力学中的热函数(heat function)形式相同,香农将其命名为information entropy(信息熵),记为H(p1,⋯,pn)。由于这是用于刻画信息量的熵,所以称为信息熵。熵是刻画概率分布性质的函数。一个概率分布的熵越大,意味着这个编码这个概率分布坍缩到每个样本的行为越困难——需要更多的符号去描述该概率分布的行为。从这个角度看,熵刻画概率分布的“不确定性(uncertainty)”,因为越不确定的东西越需要更多的成本来描述。
香农最早是这样找到这个表达式的,它认为熵函数要满足一下三个基本要求:
- 首先,对于均匀分布,熵就等于可能情况数的对数。这是因为在均匀分布时,最优编码方案是显然的;
- 其次,熵应当是一个连续的函数。一个50%正面向上的硬币的不确定性,与一个50.01%正面向上的硬币的不确定性没有理由有很大差别;
- 最后,熵在多轮询问下要有加性:考虑一个不均匀分布的随机变量X,X=a的概率为1/2,X=b的概率为1/3,X=c的概率为1/6。那么,X的分布为{1/2,1/3,1/6},这个分布对应的熵为H(1/2,1/3,1/6)。当我们想要获知X的取值时,首先询问是否成立X=a,这个问题的答案的不确定性为H(1/2,1/2);如果答案为否(这一事件发生的概率为1/2),那么我们再次询问是否成立X=b,这个问题的答案的不确定性为H(2/3,1/3)。那么,我们希望H应当满足以下的分解性质:H(1/2,1/3,1/6)=H(1/2,1/2)+1/2H(2/3,1/3);
综上所述,我们想找的函数H(p1,⋯,pn)要满足以下三条基本性质:
- H(1/n,⋯,1/n)=log2n;
- H是连续函数;
- H(p1,⋯,pn−1,αpn,(1−α)pn)=H(p1,⋯,pn−1,pn)+pnH(α,1−α);
我们来推导这三条性质的必要条件:对于任何一个离散的分布{p1,⋯,pN},如果pi都是有理数,我们总可以设存在整数n1,⋯,nN使得pi=n1+⋯+nNni。设S=n1+⋯+nN,所以分布{p1,⋯,pN}可以分解为S个样本的均匀分布,并且该分解满足性质3。这意味着,log2(S)=H(p1,⋯,pn)+∑pilog2(ni)。这就导出了H(p1,⋯,pn)=−∑pilog2(ni)+log2(S) =−∑pilog2(ni)+∑pilog2(S) =−∑pilog2(Sni) =∑pilog2pi1。
平均分布具有最大熵
对于一个随机变量X,当其均匀分布时,它就具有最大的熵。只要分布稍不均匀,熵就会降低。
证明:
均匀分布时,H(X)=log∣X∣。而对于H(X)=x∈X∑p(x)logp(x)1,我们把它看作在上凸函数logx上分别以p(x)的权重选取xi=p(x)1,由Jensen不等式可得H(X)≤log(x∈X∑p(x)⋅p(x)1)=log∣X∣。当且仅当p(x)=∣X∣1时取到等号。由此可见,离散的随机变量的熵始终满足0≤H(X)≤log∣X∣,均匀分布时取到最大值。
证毕。
联合熵(Joint Entropy)
两个随机变量的联合分布可以导出“联合熵”。这是很自然的,因为熵是一个仅仅关于分布的函数,只需要一系列离散的概率密度就可以定义。设X,Y有联合分布的密度函数p(x,y),那么定义X,Y的联合熵为H(X,Y)=−x∈X∑y∈Y∑p(x,y)logp(x,y)。从期望的角度,H(X,Y)=−\E[logp(X,Y)]。事实上,我们可以把(X,Y)看作一个整体(一个随机向量),那么X,Y联合分布的概率密度实际就是这单个随机向量的概率分布,它衡量这个随机向量(另一个新的随机变量)的不确定性。从对称性容易看出,H(X,Y)=H(Y,X)。
容易验证,如果X=Y,那么p(x,y)>0当且仅当x=y,p(x,x)=p(x),代入定义式可得H(X,X)=−x∈X∑y∈X∑p(x,y)logp(x,y)=−x∈X∑p(x,x)logp(x,x) −x∈X∑p(x)logp(x)=H(X)。所以,两个相同的随机变量的联合熵就等于单个随机变量的熵。从信息量的角度,增加一个相同的随机变量并没有增加信息量。
如果X是Y的函数,也即Y确定时X会被唯一确定,那么y确定时使得p(x,y)>0的只有唯一的x,因此p(x,y)=p(y)。于是代入定义可得H(X,Y)=−x∈X∑y∈Y∑p(x,y)logp(x,y) =−y∈Y∑p(y)logp(y)=H(Y)。X的信息完全被包含在Y以内,因此增加X并不能带来更多的信息。
如果X,Y独立,那么p(x,y)=p(x)p(y)。那么H(X,Y)=−x∈X∑y∈Y∑p(x)p(y)[logp(x)+logp(y)] =−x∈X∑p(x)logp(x)y∈Y∑p(y)−x∈X∑p(x)y∈Y∑p(y)logp(y) =H(X)+H(Y)。两个独立的随机变量的熵恰好是它们熵的和。X,Y中并没有互相重叠的信息。
联合熵可以继续推广到多元:定义H(X1,⋯,Xn)=−∑p(x1,⋯,xn)logp(x1,⋯,xn) =−\E[logp(X1,⋯,Xn)]。
条件熵(Conditional Entropy)
由随机变量的条件分布可以导出条件熵。对于两个离散随机变量X,Y,p(Y∣X=x)依然是一个概率分布,由此定义H(Y∣X=x)=−y∈Y∑p(y∣X=x)logp(y∣X=x)。从期望的角度,可以写作−\E[logp(y∣X=x)]。基于H(Y∣X=x),定义X,Y的条件熵H(Y∣X)=x∈X∑p(x)H(Y∣X=x)。它表示已知X时Y的不确定性,而“已知X”是期望意义下的已知。展开H(Y∣X=x)这一项,得到H(Y∣X)=−x∈X∑y∈Y∑p(x)p(y∣x)logp(y∣x)。而p(x)p(y∣x)=p(x,y),因此得到条件熵的一般表达式H(Y∣X)=−x∈X∑y∈Y∑p(x,y)logp(y∣x) =−\E[logp(Y∣X)]。
注意,H(X∣Y)一般不等于H(Y∣X)。但可以证明:H(X∣Y)+H(Y)=H(Y∣X)+H(X)=H(X,Y)。这称为熵的计算的链式法则。这可以从概率的链式法则p(x,y)=p(x∣y)p(y)直接导出:从期望的角度,H(X,Y)=−\E[logp(X,Y)]=−\E[logp(X∣Y)+logp(Y)] =H(X∣Y)+H(Y)。另一个是对称的。推广到n元情形:H(X1,⋯,Xn)=i=1∑nH(Xi∣Xi−1,⋯,X1)。
同样的,根据条件概率的定义容易验证p(x,y∣z)=p(x∣z)⋅p(y∣x,z)。用同样的方法可以证明H(X,Y∣Z)=H(X∣Z)+H(Y∣X,Z)。
当X是Y的函数时,H(X,Y)=H(Y)。而H(X,Y)=H(Y)+H(X∣Y),可见此时H(X∣Y)=0,Y已知时X没有任何不确定性。而反过来,如果H(X∣Y)=0,那么x∈X∑y∈Y∑p(x,y)logp(x∣y)=0,这当且仅当p(x∣y)恒等于1,也即y确定x确定,X是Y的函数。综上我们得到,X=f(y)⟺H(X∣Y)=0。
Mutual Information(互信息)
比较H(Y∣X)与H(Y)的大小,从直观上,“X已知”本身提供了信息,这一信息势必会使得Y的不确定性降低,或至少不会让Y变得更不确定。因此应当成立不等式H(Y∣X)≤H(Y)。什么时候成立等号呢?代入H(Y∣X)=H(X,Y)−H(X),等号成立时H(X,Y)=H(X)+H(Y)。我们先前验证了,如果X,Y是独立的,那么这个等式就成立。直观上,这个不等式(也即差值H(Y)−H(Y∣X))在衡量随机变量X,Y之间距离独立还有多远。我们定义这个差值为X,Y的互信息I(X;Y)=H(Y)−H(Y∣X)(或对称的I(X;Y)=H(X)−H(X∣Y))。代入化简可得I(X;Y)=x∈X∑y∈Y∑p(x,y)logp(x)p(y)p(x,y)。互信息具有对称性:I(X;Y)=I(Y;X)。从信息的角度,它描述X,Y之间有多少共同的信息。如果没有共同的信息(独立),那么互信息为0。
事实上,表达式x∈X∑p(x)logq(x)p(x)是一种用来衡量分布之间“距离”的一般方式,它称为Kullback-Leibler距离,记为D(p(x)∣∣q(x)),又称为分布分别为p,q的两个随机变量的相对熵(Relative Entropy)。互信息可以用KL距离写作I(X;Y)=D(p(x,y)∣∣p(x)p(y))。(注意,Kullback-Leibler距离是不具有对称性的)
下面我们证明,始终成立D(p(x)∣∣q(x))≥0。这是信息论中最重要的不等式之一,称为信息不等式(Information Inequality)。根据定义,D(p(x)∣∣q(x))=x∈X∑p(x)logq(x)p(x)=−x∈X∑p(x)logp(x)q(x)。由于log是上凸函数,根据Jensen不等式有x∈X∑p(x)logp(x)q(x)≤log(x∈X∑p(x)⋅p(x)q(x)) =log1=0。因此D(p∣∣q)≥0。由于Jensen不等式只在所有点都重合时取等,因此当且仅当p,q为同一分布时D(p∣∣q)=0。由I(X;Y)=D(p(x,y)∣∣p(x)p(y)),可得I(X;Y)≥0。信息不等式表明,互信息始终是非负的!
作为例子,我们取q为均匀分布,也即q(x)≡∣X∣1,那么D(p∣∣q)=x∑p(x)logp(x)+x∑p(x)log∣X∣ =log∣X∣−H(X)。由于D(p∣∣q)≥0,这再次表明H(X)只能在均匀分布时取到最大值log∣X∣。后续在微分熵中,这是更普适的证明方法。
信息图(The Information Diagram)
X,Y的熵、联合熵、互信息始终满足H(X,Y)=H(X)+H(Y)−I(X;Y)。这意味着,我们可以用韦恩图来理解熵与互信息的关系:H(X),H(Y)是单个圆的面积,H(X,Y)是并集的面积,而I(X;Y)是交集的面积。H(X∣Y)是Y去掉X部分的面积,H(Y∣X)是X去掉Y部分的面积。
我们可以把信息图推广到以下的三元情形:
在熵与联合熵中,只会涉及逗号与竖线,其中逗号表示对两块面积取并,竖线表示去除对应部分的面积,逗号的优先级高于竖线。在互信息中,会出现分号,其中分号表示对两块面积取交,分号的优先级高于竖线,低于逗号。综合起来,优先级从高到低为,>;>∣。我们可以验证,根据信息图做恒等变形始终是成立的。其中,为I(X;Y∣Z)=H(X∣Z)−H(X∣Y,Z)称为条件互信息(Conditional Mutual Information)。条件互信息也具有非负性。I(X1;X2;X3)仅仅是一个形式上的记号,它并不是互信息,不具有非负性(它也是信息图中唯一可能取负值的一片区域。我们可以证明,当X=Y=Z时I(X;Y;Z)>0,而Z=X+Y时I(X;Y;Z)<0。)
信息图为我们完整描述了三元以内的所有熵与互信息之间的等式关系。而对于三元以上的信息图,我们不能找到一个把它在平面上画出来的简单方式。但是可以验证,以下基于信息图的理解经过验证在三元以上的情形也是正确的:
①熵的链式法则:H(X1,⋯,Xn)=i=1∑nH(Xi∣X1,⋯,Xi−1)(一系列面积取并,等价于每次累加一个新面积去除已经计算过的所有面积);
②互信息的链式法则:I(X1,⋯,Xn;Y)=i=1∑nI(Xi;Y∣Xi−1,⋯,X1)(一系列面积与另一个面积取交,等价于每次累加一个面积与它的交去除所有已经计算过的部分);
③互信息与熵的转化:I(X1,⋯,Xn;Y)=H(X1,⋯,Xn)−H(X1,⋯,Xn∣Y)(将(X1,⋯,Xn)看作一个随机向量);
把H(X∣Y)≤H(X)中的X,Y看作随机向量推广到多元,可以验证不等式依然成立。那么基于熵的链式法则H(X1,⋯,Xn)=i=1∑nH(Xi∣X1,⋯,Xi−1),可以得到以下不等式,称为The Independence Bound: H(X1,⋯,Xn)≤i=1∑nH(Xi)。这直观上表明n个随机变量联合熵总是不超过各自熵的和。这种系统间的相互影响(重叠的信息)而造成的。如果n个变量全都互相独立,那么恰好取到等号。这个不等式可以看作信息不等式的一个推论。信息图中真正本质的不等关系只有信息不等式一个(而它的本质是Jensen不等式)。
同样的,基于D(p∣∣q)=\Ep[logq(x)p(x)],可以定义条件相对熵(Conditional Relative Entropy) D(p(y∣x)∣∣q(y∣x))=\Ep(x,y)[logq(Y∣X)p(Y∣X)] =x∑y∑p(x,y)logq(y∣x)p(y∣x)。
对于D(p(x,y)∣∣q(x,y)),会出现logq(x,y)p(x,y)一项,根据条件概率可以展开为logq(x)q(y∣x)p(x)p(y∣x)=logq(x)p(x)+logq(y∣x)p(y∣x)。因此D(p(x,y)∣∣q(x,y))=D(p(x)∣∣q(x))+D(p(y∣x)∣∣q(y∣x))。这是相对熵的链式法则。
马尔科夫链(Markov Chain)
一般来说,根据链式法则,三个随机变量的分布满足p(x,y,z)=p(x)p(y∣x)p(z∣x,y)。假如我们发现分布可以进一步满足p(x,y,z)=p(x)p(y∣x)p(z∣y),也即在X,Y,Z的联合分布中Z总是只依赖于Y而不依赖于X,就称这三个随机变量形成了马尔可夫链X→Y→Z。一个很常见的情形是,Z=f(Y),此时自然有X→Y→f(Y)。
对于X→Y→Z,根据马尔可夫链定义,由p(x,z∣y)=p(y)p(x,y,z) =p(y)p(x)p(y∣x)p(z∣y) =p(y)p(x,y)p(z∣y)=p(x∣y)p(z∣y)。这说明,马尔可夫链等价于在中间随机变量的条件概率意义下,前后的两个事件是独立的。而这样的定义是对称的,因此X→Y→Z一定同时意味着Z→Y→X.
对于马尔可夫链,变量之间的互信息满足以下重要的不等式,称为数据处理不等式(Data-processing inequality):如果X→Y→Z,那么I(X;Y)≥I(X;Z)。 它表明,在马尔可夫链中相距更近的两个变量之间的关联一定比更远的变量更紧密。仅仅通过处理Y的数据来得到的变量Z不可能帮助我们获得更多信息。证明如下:由于X→Y→Z,因此在Y的条件下X,Z独立,那么有I(X;Z∣Y)=0。根据链式法则,I(X;Y,Z)=I(X;Z)+I(X;Y∣Z),对称的也有I(X;Y,Z)=I(X;Y)+I(X;Z∣Y)=I(X;Y)。因为I(X;Y∣Z)≥0,因此I(X;Z)≤I(X;Y)。
根据I(X;Y)=H(X)−H(X∣Y),I(X;Z)=H(X)−H(X∣Z),数据处理不等式也可以等价地写为H(X∣Y)≤H(X∣Z)。这说明给定一个马尔可夫链上间隔越远的已知条件,对不确定性的约束效果更弱。
在马尔可夫链中,由于I(X;Z∣Y)恒为0,因此我们不需要韦恩图中(X∩Z)∖Y那一片区域,因此可以把韦恩图画成三个山峰的形式。多元的马尔可夫链的韦恩图也是类似的(要保证X1和Xn相交)。


